Blog / QA antes de subir código: por que nunca edito produção direto
QA antes de subir código: por que nunca edito produção direto
Por Marcos Henrique Corrêa · tecnologia ·
A diferença entre um projeto pessoal que quebra sozinho de vez em quando e um que fica estável por meses não é sorte. É uma rotina chata de verificação antes de cada mudança ir ao ar. Nada sofisticado, só disciplina repetida.
Dois ambientes, duas realidades
O marck0101 roda em dois ambientes completamente separados. Desenvolvimento usa um banco de dados só meu, na minha máquina. Produção usa um banco na nuvem, o que está realmente no ar. São dois endereços de conexão diferentes, escolhidos automaticamente dependendo de onde o sistema está rodando — nunca aponto os dois pro mesmo banco, nem por engano.
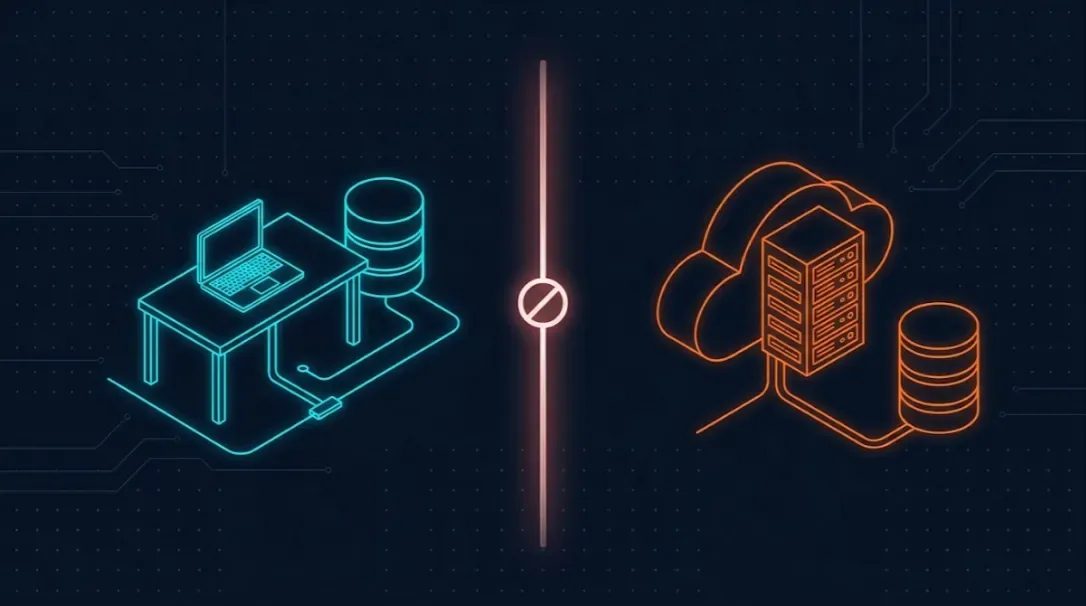
Essa separação existe por um motivo simples: em desenvolvimento, posso quebrar, testar, apagar tudo e recomeçar, sem medo nenhum. Se esse mesmo banco fosse o de produção, cada teste seria um risco real pro conteúdo que já está publicado e sendo lido.
Toda funcionalidade nova é, na verdade, dois sistemas
Quando você constrói uma feature, parece que está construindo uma coisa só. Na prática, está construindo duas: o pedaço novo que você queria, e a garantia de que tudo que já existia continua funcionando exatamente como antes. A segunda parte é invisível — ninguém comemora "testei e nada quebrou" — mas é ela que decide se o sistema continua confiável depois de cem mudanças, não só depois da primeira.
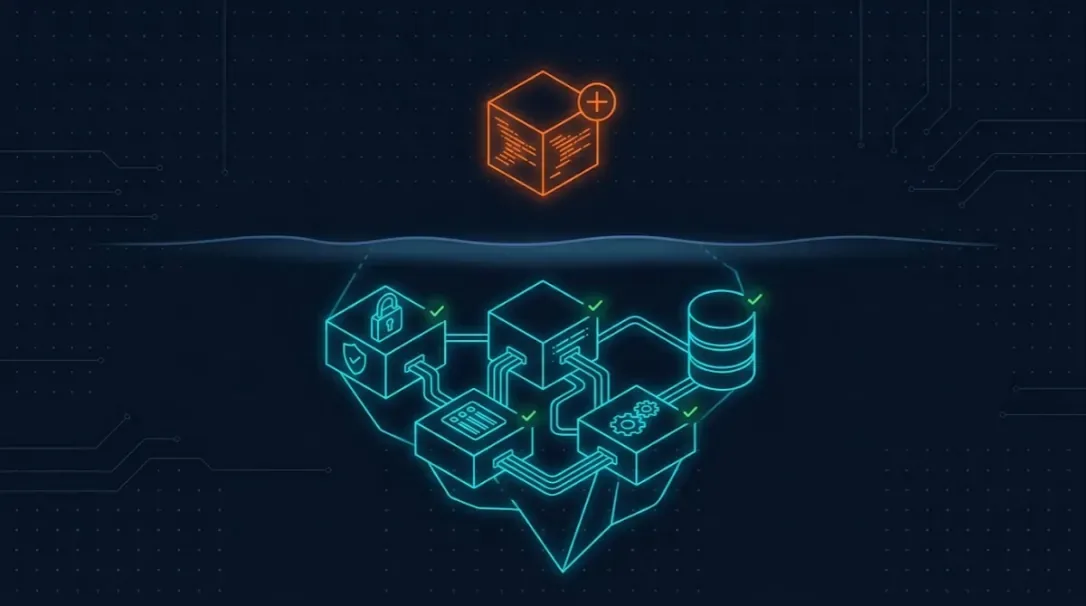
É por isso que testar só a funcionalidade nova nunca é suficiente. Adicionar recuperação de senha, por exemplo, significa testar o fluxo de recuperação. Mas também voltar e confirmar que o login comum continua funcionando, que o acesso antigo não foi invalidado por engano, que nenhuma outra parte do sistema quebrou com o campo novo. Esse "resto que não deveria ter mudado" é, na maioria das vezes, maior e mais fácil de esquecer do que a parte nova que todo mundo está olhando.
O que "QA" significa para um projeto de uma pessoa só
QA (de Quality Assurance, garantia de qualidade) parece coisa de equipe grande, com testador dedicado. Num projeto pessoal, é mais simples — e ainda assim indispensável. Antes de qualquer código subir, eu gero a versão final do site na minha própria máquina. Se tiver algum erro de construção, eu descubro ali, não depois de publicar. Testo o fluxo manualmente: clico no botão que mudei, preencho o formulário que ajustei, confiro se a resposta é a esperada. Pras mudanças de backend, subo o servidor local e testo as rotas novas da API — os "endereços" que o frontend chama pra buscar ou salvar dado — com uma chamada real, antes de considerar pronto.
Não é sobre ter cobertura de teste automatizado perfeita. É sobre nunca assumir que uma mudança funciona só porque "parece certa" no código. Cada funcionalidade que documentei nos posts anteriores desta série — recuperação de senha, contador de visualizações, FAQ com dados estruturados — passou por esse mesmo ciclo: gerar a versão final, testar manualmente, só depois publicar.
Por que isso evita o erro caro
O erro que QA evita não é o bug óbvio — esse você vê na hora. É o erro silencioso: uma mudança no banco que funciona com dados de teste mas quebra com um caso real que só existe em produção; uma mudança na API que o frontend não percebeu porque ninguém testou o fluxo completo, só uma parte isolada. Esse tipo de erro não aparece no código — aparece no comportamento. E só aparece se alguém, ou algo, efetivamente usar o sistema antes de ele ir ao ar pra valer.
O que ainda não automatizei
Sendo honesto: não tenho testes automatizados cobrindo todo o sistema — a verificação ainda é manual, feita por mim, a cada mudança. Funciona porque o projeto é pequeno o suficiente pra eu segurar o contexto inteiro na cabeça. Se o marck0101 crescesse em equipe ou complexidade, esse processo manual precisaria virar testes automatizados de verdade — é um limite que reconheço, não um problema que estou ignorando.
No fim, a regra é simples e não depende de ferramenta nenhuma: nunca testar em produção o que dá pra testar antes. Rotina chata, resultado visível.
Com as decisões específicas fechadas — arquitetura, segurança, performance, funcionalidades, processo — os dois últimos posts antes do fechamento da série cruzam tudo isso: como SEO e GEO se apoiam em cada uma dessas camadas, e como os dados que o próprio blog gera viram decisão de conteúdo.