Blog / Monólito ou dois repositórios? Por que separei front e back do zero
Monólito ou dois repositórios? Por que separei front e back do zero
Por Marcos Henrique Corrêa · tecnologia ·
Depois da reflexão mais ampla sobre times e IA, esta série entra nas decisões específicas do marck0101. Começo pela mais estrutural de todas: como o próprio sistema foi organizado.
Resumo
Este artigo analisa, como estudo de caso, a decisão de construir o blog marck0101 com frontend e backend separados — dois repositórios, dois deploys e um contrato de API entre eles — em vez de um sistema único (monólito). A pergunta central é: essa separação compensa num projeto de uma pessoa só? Foram testadas três hipóteses: deploy independente, falhas isoladas e carregamento mais leve para o leitor. As três se confirmaram, mas com um custo claro: a comunicação entre os dois lados vira um ponto de quebra silenciosa, que só é controlado com um contrato de API documentado. A conclusão é que a separação vale quando a fronteira entre as partes é estável e conhecida — e frontend/backend é uma das fronteiras mais estáveis que existem.
Em uma frase, para quem decide: separar o site da API custou um pouco mais de configuração no início, e em troca permitiu publicar mudanças com menos risco, manter o blog de pé quando uma parte falha e entregar páginas mais leves ao leitor.
1. Introdução: o contexto
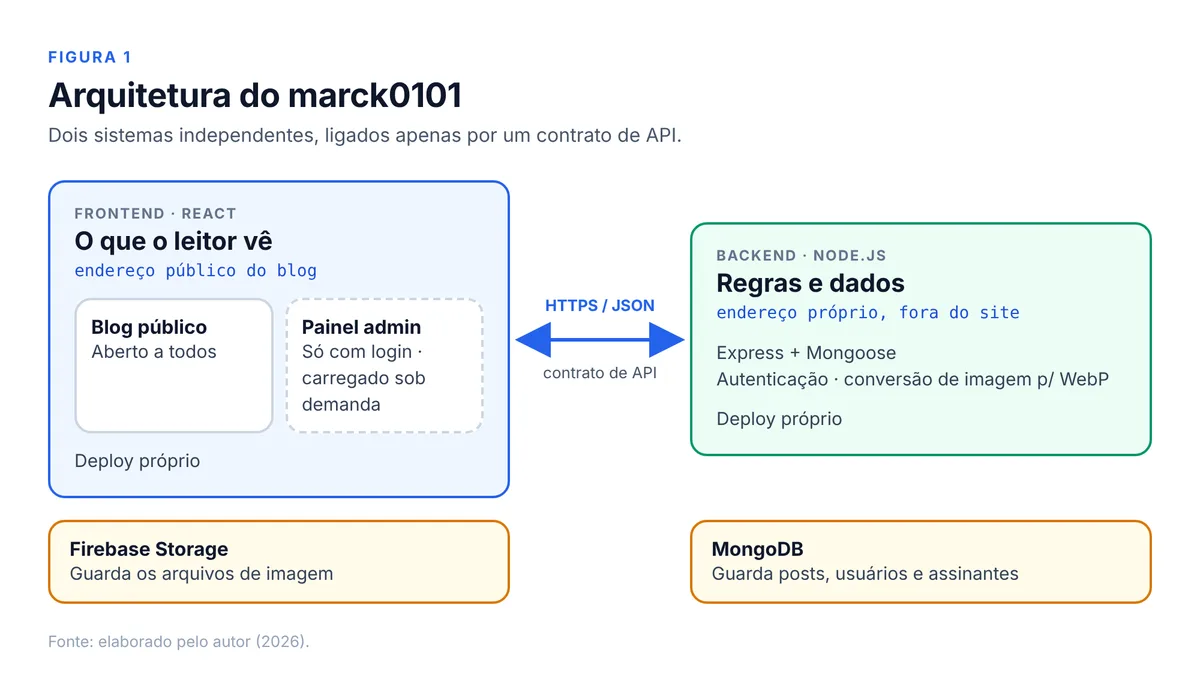
Antes de escrever a primeira linha de código do marck0101, tomei uma decisão que molda tudo até hoje: backend e frontend seriam dois projetos separados, em dois repositórios, com dois deploys independentes. Não é um único sistema que serve página e API ao mesmo tempo.
Essa é uma escolha de arquitetura de software — o desenho de como as partes de um sistema se dividem e conversam. Ela parece técnica, mas tem efeito direto no negócio: define quanto custa mudar o produto, quanto risco cada mudança carrega e quão rápido a página chega até quem lê.
Na literatura, Ford e Richards (2020) resumem a área numa regra: tudo em arquitetura de software é uma troca. Não existe a opção certa em abstrato, só a opção que troca os custos certos para o contexto. Este artigo documenta qual troca foi feita aqui, por quê, e o que ela entregou.
2. O problema: por que essa decisão importa
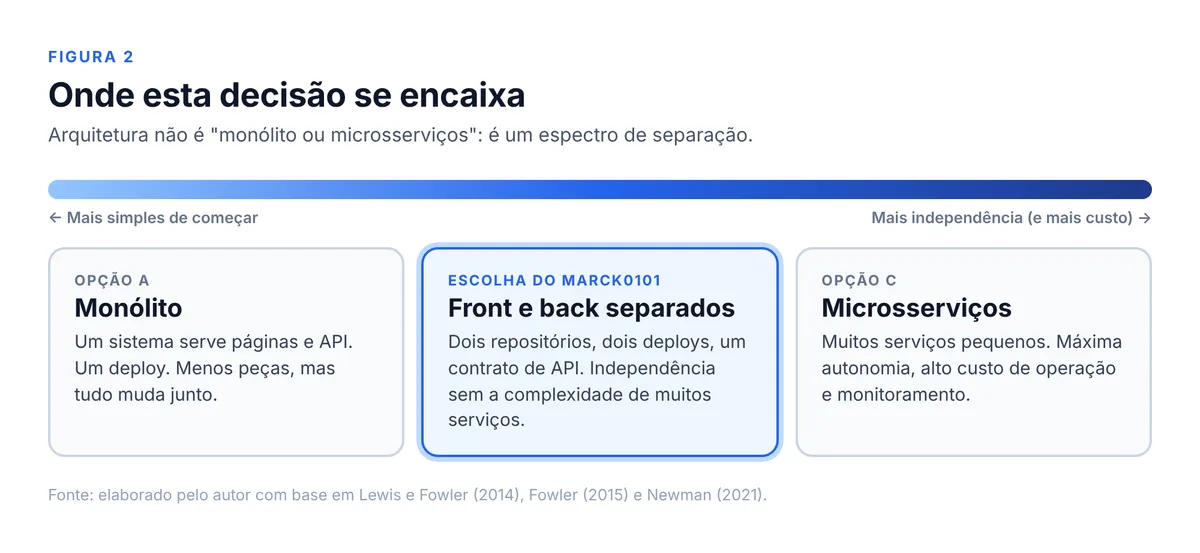
Um projeto pessoal cabe inteiro num único processo — é mais simples de começar, e boa parte da indústria recomenda exatamente isso. Fowler (2015) observa que quase todas as histórias de sucesso com sistemas distribuídos começaram como um monólito que cresceu demais, e que sistemas construídos já separados desde o início costumam ter problemas sérios. Em 2023, o time do Prime Video, da Amazon, mostrou o caso inverso na prática: ao juntar um serviço que estava distribuído em várias partes, reduziu o custo de infraestrutura em 90% (KOLNY, 2023).
Por outro lado, Tilkov (2015) argumenta que, quando as fronteiras entre as partes são conhecidas de antemão, separar cedo evita um acoplamento difícil de desfazer depois. E a pesquisa do programa DORA, publicada em Accelerate (FORSGREN; HUMBLE; KIM, 2018), mostra que times com arquitetura de baixo acoplamento — em que cada parte pode ser testada e publicada sem depender das outras — entregam com mais frequência e com menos falhas.
O problema, portanto, é escolher um lado de um debate que não tem resposta universal. A pergunta de pesquisa deste estudo é: num projeto de uma pessoa só, separar frontend e backend desde o início gera benefícios que superam o custo extra de manter dois sistemas?
3. Para quem é este texto
Diretoria e gestão: para entender, sem jargão, por que decisões de arquitetura afetam risco, custo e velocidade de entrega — e que perguntas fazer ao time antes de aprovar uma.
Analistas e desenvolvedores: para ver um caso real, com a stack, as hipóteses e os problemas concretos que apareceram, e usar como referência em decisões parecidas.
Quem está começando um projeto do zero: para ter um critério simples de quando separar e quando manter tudo junto.
4. Referencial teórico
Três ideias sustentam a análise.
Módulos devem esconder o que muda. Parnas (1972) propôs que um sistema deve ser dividido de forma que cada parte esconda das outras as decisões com maior chance de mudar. A tela que o leitor vê muda o tempo todo; as regras de negócio e os dados mudam bem menos. Isso faz de frontend/backend uma fronteira natural.
Contratos explícitos entre as partes. Quando dois sistemas conversam, o que os mantém compatíveis é um contrato: o formato das requisições e respostas. Robinson (2006) descreve o modelo de contratos orientados ao consumidor, em que quem usa a API declara do que depende, para que quem fornece saiba o que não pode quebrar. Newman (2021) reforça que, sem esse contrato, a separação vira acoplamento disfarçado.
Isolar falhas. Nygard (2018) usa a metáfora das anteparas de um navio (bulkheads): compartimentos separados fazem com que um vazamento num deles não afunde o barco inteiro. Em software, a ideia é a mesma — uma falha numa parte não deveria derrubar todas as outras.
5. Hipóteses
A partir desse referencial, a decisão foi tomada apostando em três hipóteses:
H1 — Deploy independente: mudanças no painel administrativo ou na API podem ir ao ar sem exigir — nem arriscar — uma nova versão do outro lado.
H2 — Falhas isoladas: se um dos lados cair, o outro continua funcionando, ao menos parcialmente.
H3 — Leitura mais leve: o leitor do blog não precisa baixar o código do painel administrativo, e as páginas carregam mais rápido.
E com um custo esperado: mais esforço de coordenação entre os dois sistemas.
6. Metodologia: como e onde
Trata-se de um estudo de caso único, de natureza qualitativa, conduzido no próprio blog marck0101 durante seu desenvolvimento e operação. As hipóteses foram avaliadas pela observação direta do dia a dia — publicações, atualizações, falhas e correções — e comparadas com o que a literatura citada prevê.
Onde o sistema roda e com o quê:
Backend — Node.js, Express e Mongoose (a camada que conecta o código ao banco MongoDB). Cuida da autenticação — detalhada no próximo post — e converte automaticamente as imagens enviadas para o formato WebP, mais leve. Roda num endereço próprio, separado do site que o leitor acessa.
Frontend — React, com o Firebase cuidando do armazenamento das imagens (o backend processa e envia, mas não guarda o arquivo). É o endereço público do blog. Dentro do mesmo site moram duas áreas: o blog público e o painel administrativo, este com acesso restrito por login.
Os dois lados se comunicam apenas por chamadas HTTPS à API, trocando dados em JSON. Nenhum acessa o banco ou os arquivos do outro diretamente.
7. Resultados e discussão
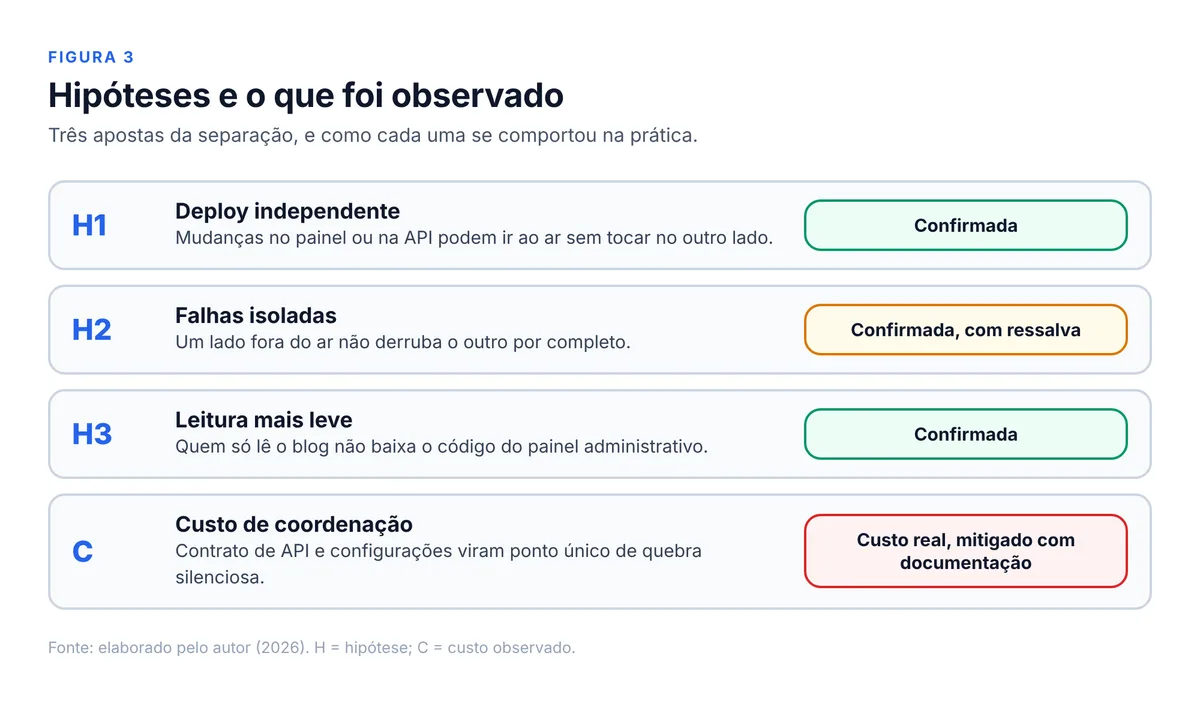
H1 — Deploy independente: confirmada
Uma mudança no editor de posts do painel não precisa esperar — nem arriscar — uma nova versão do site que o leitor está acessando agora. O inverso também vale: uma correção na API vai ao ar sem tocar no frontend. Na prática, isso reduz o tamanho de cada mudança, e mudanças menores são mais fáceis de testar e de desfazer, como apontam Forsgren, Humble e Kim (2018).
H2 — Falhas isoladas: confirmada, com ressalva
Se o backend cair, o blog público ainda carrega os posts que já estão salvos no navegador do leitor. Se o frontend quebrar numa atualização, a API continua respondendo para quem só precisa dela. É a lógica das anteparas de Nygard (2018) aplicada em pequena escala.
A ressalva: o isolamento é parcial. Com o backend fora do ar, conteúdo novo, login e painel param. A separação não elimina a falha — ela limita até onde a falha chega.
H3 — Leitura mais leve: confirmada
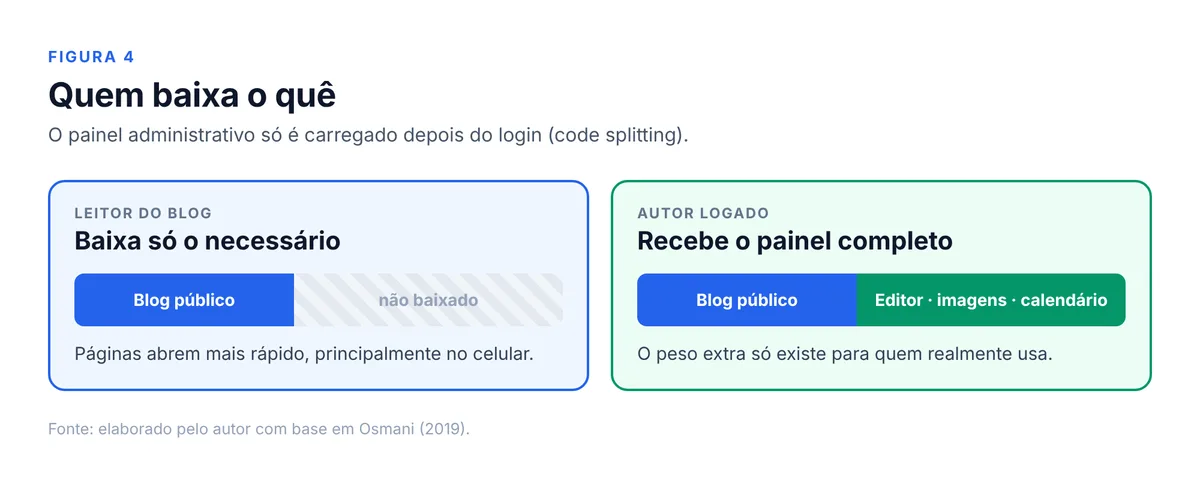
Como o painel administrativo é carregado separadamente do restante do site (técnica chamada code splitting), quem só lê o blog nunca baixa o editor de texto, o gerenciador de imagens nem o calendário. Esse peso só carrega para quem efetivamente faz login. Osmani (2019) mostra que o JavaScript enviado ao navegador está entre os recursos mais caros de uma página, principalmente em celulares — então não enviá-lo a quem não precisa é ganho direto de velocidade.
O custo observado: coordenação
Dois repositórios significam duas configurações de ambiente, duas filas de deploy e mais pontos que podem quebrar. Dois problemas apareceram na prática:
Permissões entre domínios. Como site e API estão em endereços diferentes, o navegador exige uma autorização explícita para que um converse com o outro — o mecanismo chamado CORS (MDN, 2025). Uma configuração errada aí trava o login silenciosamente, sem mensagem clara para o usuário.
Mudanças de contrato. Renomear um campo na API, por exemplo, não gera nenhum erro antes de publicar. O sistema só quebra quando já está no ar, se um dos dois lados não for atualizado junto.
A resposta foi tratar o contrato da API como parte do produto: documentá-lo, mesmo que de forma simples, deixou de ser luxo e virou obrigação — exatamente o que Robinson (2006) e Newman (2021) recomendam.
8. Conclusão
Voltando à pergunta de pesquisa: sim, a separação compensou — mas não por ser "mais moderna", e sim porque a fronteira escolhida é estável. Frontend e backend mudam em ritmos diferentes e por motivos diferentes, o que, nos termos de Parnas (1972), faz deles bons candidatos a módulos independentes.
O resultado também não contradiz Fowler (2015) nem o caso do Prime Video (KOLNY, 2023). O que esses autores criticam é separar demais ou separar cedo demais, em fronteiras ainda incertas. Aqui foi feito um único corte, num ponto bem conhecido, longe dos microsserviços.
Recomendações práticas:
Para a diretoria: antes de aprovar uma mudança de arquitetura, pergunte ao time qual fronteira está sendo criada, por que ela é estável e qual será o custo de manter as duas partes conversando.
Para analistas e desenvolvedores: se separar, documente o contrato da API desde o primeiro dia e trate configurações entre domínios (como CORS) como parte do deploy, não como detalhe.
Para quem está começando: separe só onde a fronteira for clara. Na dúvida, um sistema único bem organizado é um ponto de partida legítimo.
Limitações e próximos passos. Este é um estudo de caso único, de um projeto pequeno e operado por uma só pessoa; os resultados não devem ser generalizados para times grandes sem cautela. Um próximo passo natural é medir os ganhos com números — tempo de carregamento e frequência de deploy — em vez de apenas observá-los.
Essa separação é a base sobre a qual todo o resto do sistema — segurança, performance, funcionalidades do dia a dia — foi construído. Nos próximos posts da série, entro em cada uma dessas camadas, começando pela autenticação.
Referências
FORD, N.; RICHARDS, M. Fundamentals of Software Architecture: an engineering approach. Sebastopol: O'Reilly Media, 2020.
FORSGREN, N.; HUMBLE, J.; KIM, G. Accelerate: the science of lean software and DevOps. Portland: IT Revolution Press, 2018.
FOWLER, M. MonolithFirst. martinfowler.com, 3 jun. 2015. Disponível em: https://martinfowler.com/bliki/MonolithFirst.html.
KOLNY, M. Scaling up the Prime Video audio/video monitoring service and reducing costs by 90%. Prime Video Tech, mar. 2023. Apud: Prime Video Switched from Serverless to EC2 and ECS to Save Costs. InfoQ, maio 2023. Disponível em: https://www.infoq.com/news/2023/05/prime-ec2-ecs-saves-costs/.
MDN WEB DOCS. Cross-Origin Resource Sharing (CORS). Mozilla, 2025. Disponível em: https://developer.mozilla.org/pt-BR/docs/Web/HTTP/CORS.
NEWMAN, S. Building Microservices: designing fine-grained systems. 2. ed. Sebastopol: O'Reilly Media, 2021.
NYGARD, M. T. Release It!: design and deploy production-ready software. 2. ed. Raleigh: Pragmatic Bookshelf, 2018.
OSMANI, A. The cost of JavaScript in 2019. V8 Dev Blog, 25 jun. 2019. Disponível em: https://v8.dev/blog/cost-of-javascript-2019.
PARNAS, D. L. On the criteria to be used in decomposing systems into modules. Communications of the ACM, v. 15, n. 12, p. 1053–1058, 1972.
ROBINSON, I. Consumer-Driven Contracts: a service evolution pattern. martinfowler.com, 12 jun. 2006. Disponível em: https://martinfowler.com/articles/consumerDrivenContracts.html.
TILKOV, S. Don't start with a monolith. martinfowler.com, 9 jun. 2015. Disponível em: https://martinfowler.com/articles/dont-start-monolith.html.